Module 03 / 06
文档识别
扫描件、PDF、演示文稿与电子表格在本机完成版面分析与文字识别;识别完的内容还能再产出报告,或和另一个版本逐段比对。
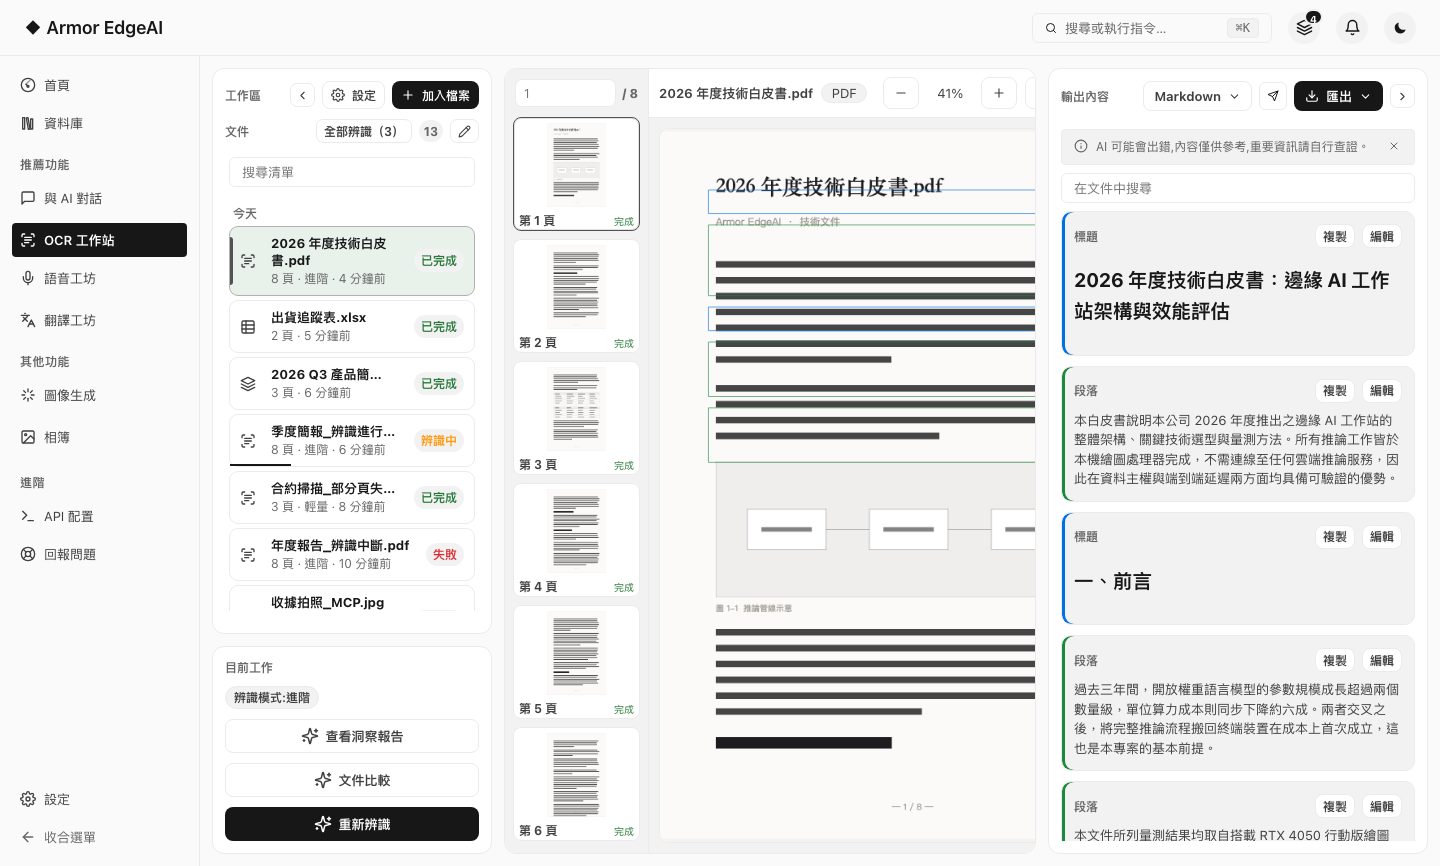
FEATURE 01
OCR 分析
两种模式:高级做完整版面分析与高精度识别,轻量把整页交给视觉模型快速转成纯文本。
- 高级:保留结构标题、段落、表格、公式各自成块,输出可逐块查看与编辑,适合报告与合同。
- 轻量:快速转文字整页直接转成纯文本,适合截图与收据;不做版面分析,也不需要下载 OCR 专用模型。
- 多种导出Markdown、Word、HTML、JSON、纯文本、CSV。
- 不只扫描件PowerPoint 与 Excel 文件也能直接读;文档列表可以一次识别全部,或设置上传后自动开始。
FEATURE 02
洞察报告
识别完成的文档可以再整理成一份多维度报告 — 不只是一段摘要。
- 十余种内容重点摘要、关键词、章节大纲、行动项、重点摘录、思维导图、词汇对照、不确定事项…。
- 可回跳原文章节与摘录可以点,直接跳回文档对应的页码。
- 可追问可导出右侧抽屉追问报告内容,或导出 HTML / Markdown。
FEATURE 03
文档比较
两份都识别完成的文档,先用算法对齐页面,再逐段整理出到底改了什么。
- 先对齐再比对页面对应关系由算法决定;只有判定有变动的页面才交给语言模型逐段分析。
- 三种查看方式只看版本一、并排、只看版本二,另可切换成只看有差异的段落。
- 诚实标记对不准的页面会标“配对置信度较低,请人工确认”,不会假装百分之百。