v1.0.11.0 正式版:6 つのツールを 1 つのワークスペースに。新機能を見る →

Product

6 つのモジュール、1 台のマシン、完全オフライン

バラバラな 6 つのツールではなく、1 つの完成したワークステーション:同じインターフェース、同じモデル管理、同じプライバシー基準。作ったものは同じライブラリに集まり、ツールから次のツールへ渡せます — 以下のどの画面も、ネットのないマシンでまったく同じに動きます。

01 — Modules

ここから 1 つ選んでください

各モジュールに専用のページがあり、機能を 1 つずつ分けて説明したうえで、実際に触れるデモを添えています。

MODULE 01 / 06

AI チャット

モデルはローカルで動作し、会話があなたのPCから出ることはありません。複数のオープンソースモデルを切り替え、思考モードと画像理解に対応した完全な AI チャット体験。

  • 長大コンテキストコンテキスト長は選択したモデルに依存し、最大 128K — 長い文書も長い会話も静かに切り捨てられません。
  • 思考モード深い推論が必要なときにオンにします(既定はオフ)。モデルの思考過程は展開して確認できます。
  • 画像理解画像をチャットにドラッグするか、添付ボタンからファイルを選ぶと、端末内のビジョンモデルが読み取ります。
  • 文書への回答PDF、Word、プレーンテキストなどの文書を添付して質問すると、引用した根拠段落を添えて回答します。
  • 開発者フレンドリーOpenAI 互換と Anthropic 互換の API エンドポイントを内蔵。ローカルのみにバインドされ、自分のツールをつなげます。
実行場所100% ローカル推論モデル複数のオープンソースモデルを切替・追加コンテキストモデル依存、最大 128K tokens
このモジュールを見る
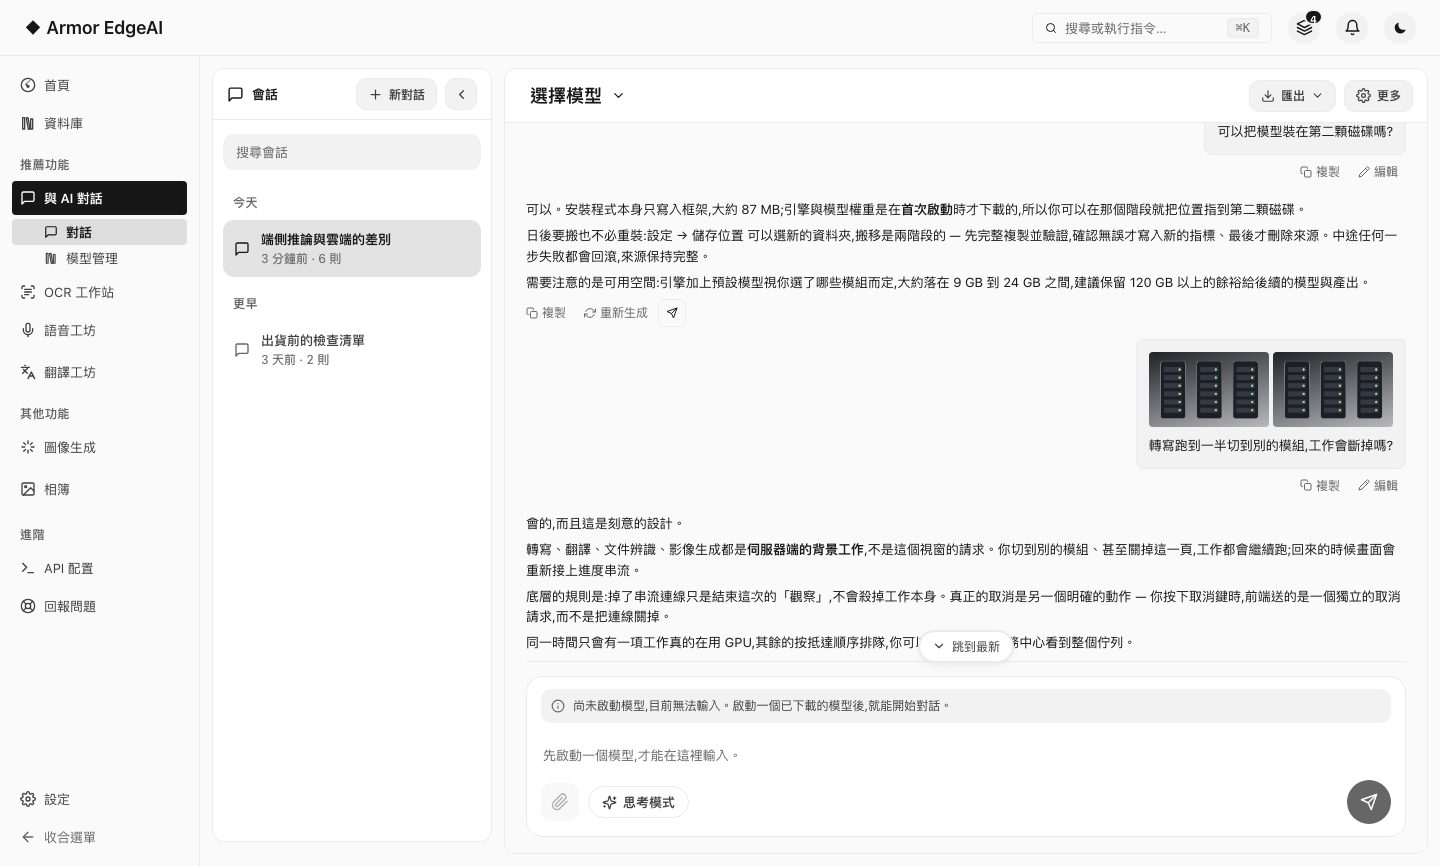
AI チャットの画面
画面はサンプルデータです

MODULE 02 / 06

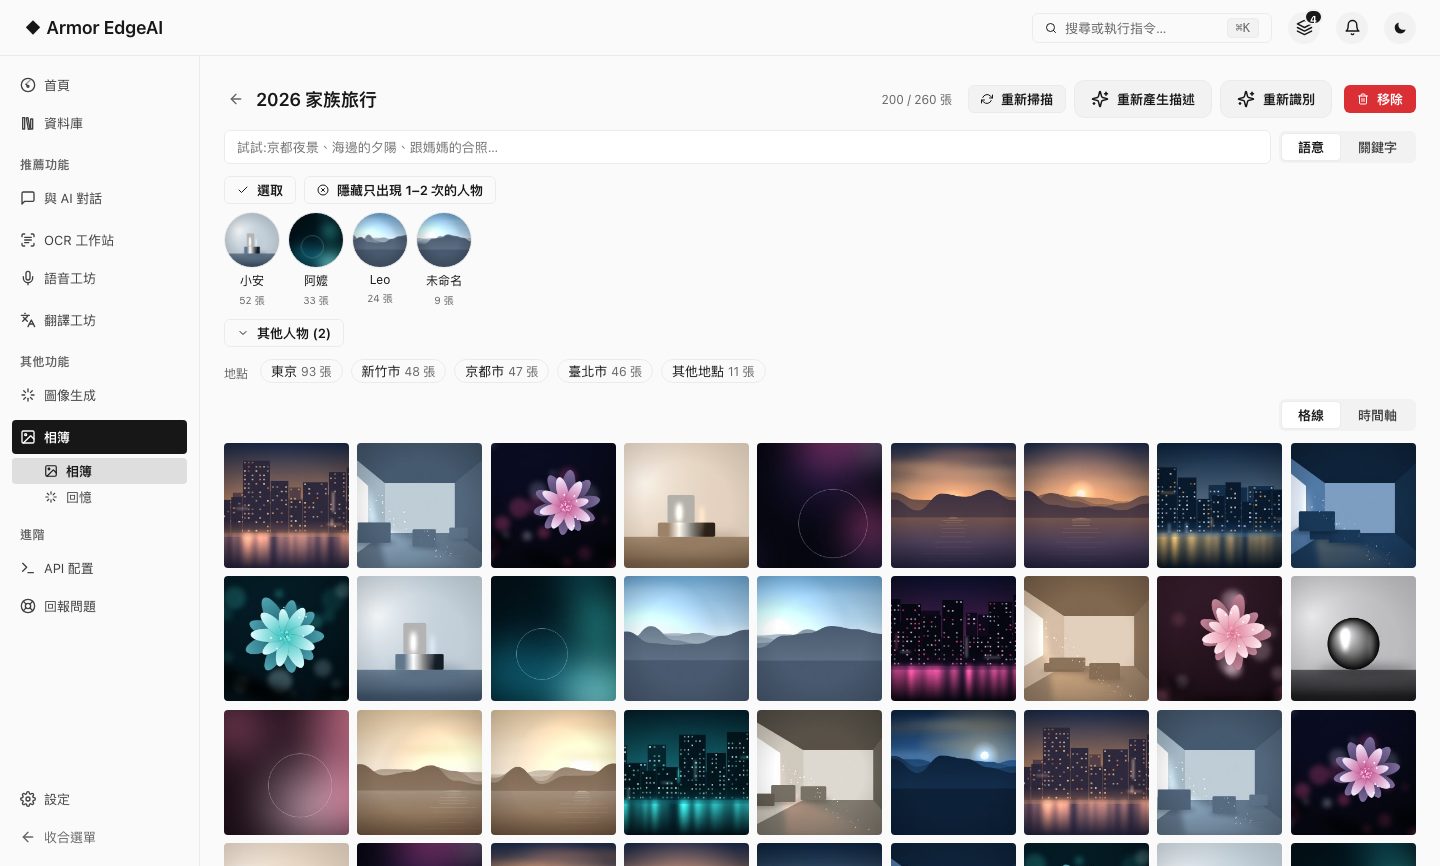
スマートアルバム

写真フォルダーを端末内のビジョンモデルに任せる:自動の説明とタグ付け、一文でのセマンティック検索、人物の自動グループ化、思い出の自動生成 — 写真は最初から最後までアップロードされません。

  • 2 つの検索セマンティックとキーワードの 2 モード。どちらも AI が各写真に書いた説明とキーワードを照合します。
  • 人物グループ化同じ人物の写真を自動で認識・整理し、名前を付けられます。
  • 思い出カード時系列で思い出カードを自動編成。1 枚ずつ没入して閲覧でき、保存もできます。
  • 写真は端末内分析・インデックス・検索はすべてローカルで完結。
実行場所100% ローカル分析・索引検索セマンティック / キーワードの 2 モード
このモジュールを見る
スマートフォトブックの画面
画面はサンプルデータです

MODULE 03 / 06

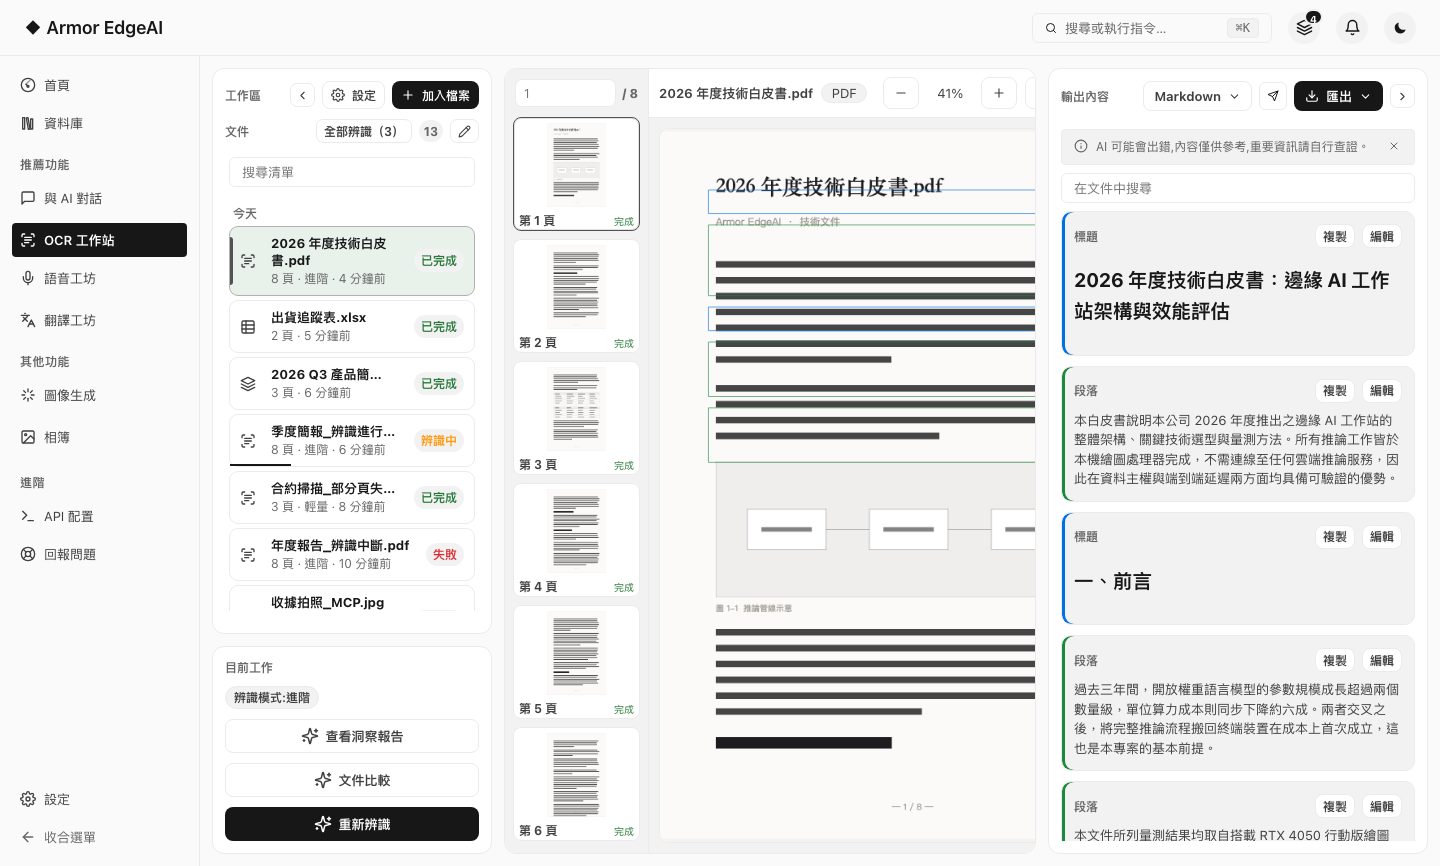
文書認識

アドバンストモードは完全なレイアウト解析と高精度認識、ライトモードはページ全体をビジョンモデルで高速テキスト化。結果は文書比較やインサイトレポートへ。

  • 2 つのモードアドバンスト(レイアウト+高精度)とライト(ページ丸ごと高速変換)を用途で切替。
  • 構造を保持表やフローチャートなどの構造化コンテンツは失われません。
  • 文書比較2 つの文書を段落単位で対照、変更が一目瞭然。
  • インサイトレポート認識した内容をそのまま要約し、レポートにまとめられます。
実行場所100% ローカル認識入力スキャン画像 / PDF / PowerPoint / Excel
このモジュールを見る
文書認識ワークステーションの画面
画面はサンプルデータです

MODULE 04 / 06

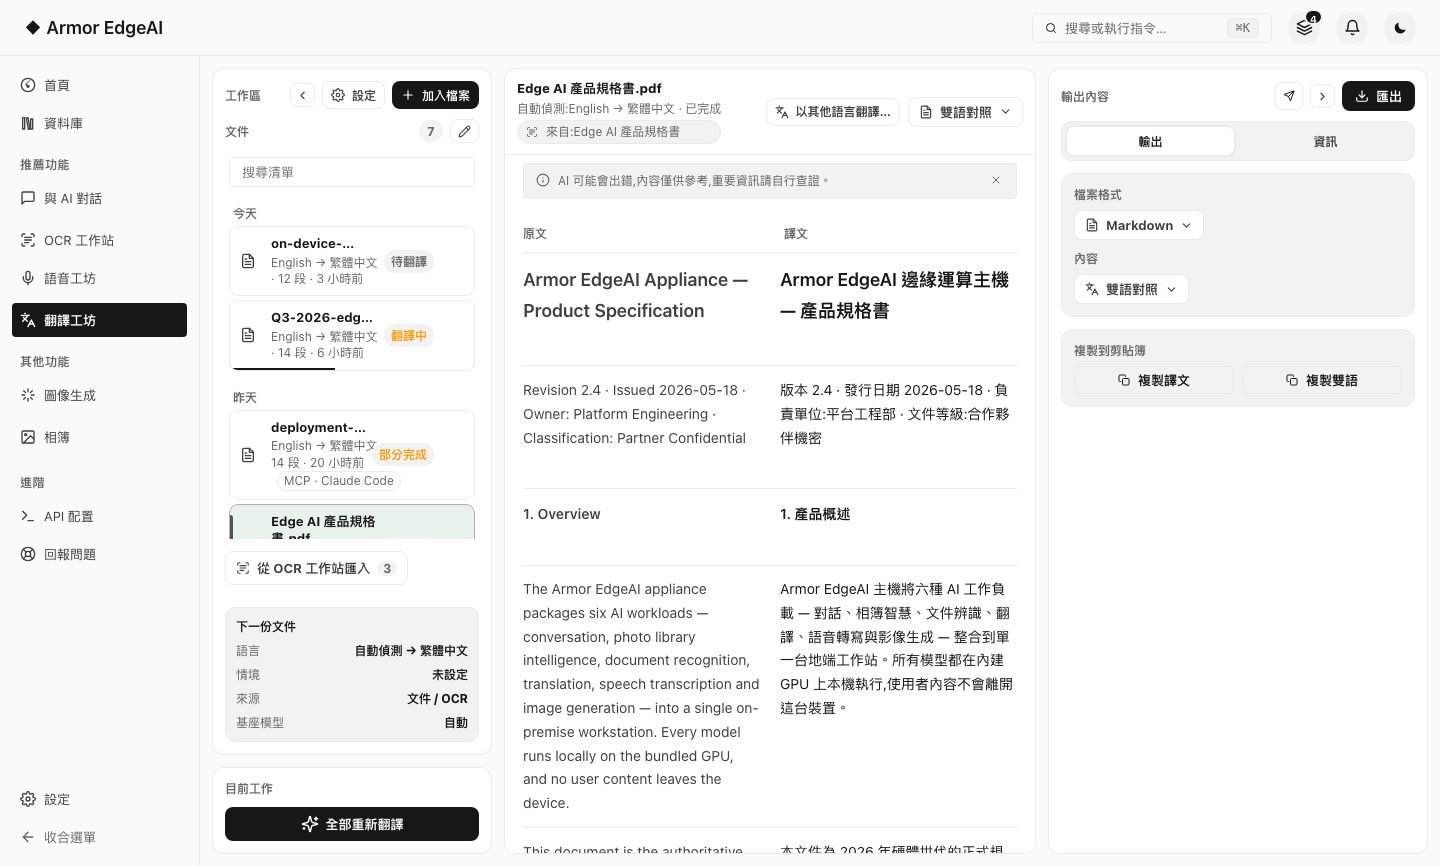
翻訳スタジオ

翻訳ボックスに放り込んで終わりではありません:文書をインポートして段落ごとに翻訳し、原文と付き合わせて納得いくまで推敲、完成したらエクスポート — 機密文書がクラウド翻訳を通ることはありません。

  • 段落ごとの推敲原文と訳文を並べて表示し、段落単位で再翻訳したり手作業で書き換えたりできます。編集した段落には印が付きます。
  • 文書単位の取り込みプレーンテキスト、Markdown、Word、CSV をそのままインポートし、段落構造を保持します。
  • コンテキスト指定この文書の分野と用途を先に伝えておくと、文書全体が同じコンテキストで翻訳され、用語がそろいます。
  • 完全オフライン契約書・決算資料・研究文書が端末から出ることはありません。
実行場所100% ローカル翻訳入力TXT / Markdown / Word / CSV / PDF / 画像 / テキスト貼り付け
このモジュールを見る
翻訳スタジオの画面
画面はサンプルデータです

MODULE 05 / 06

音声スタジオ

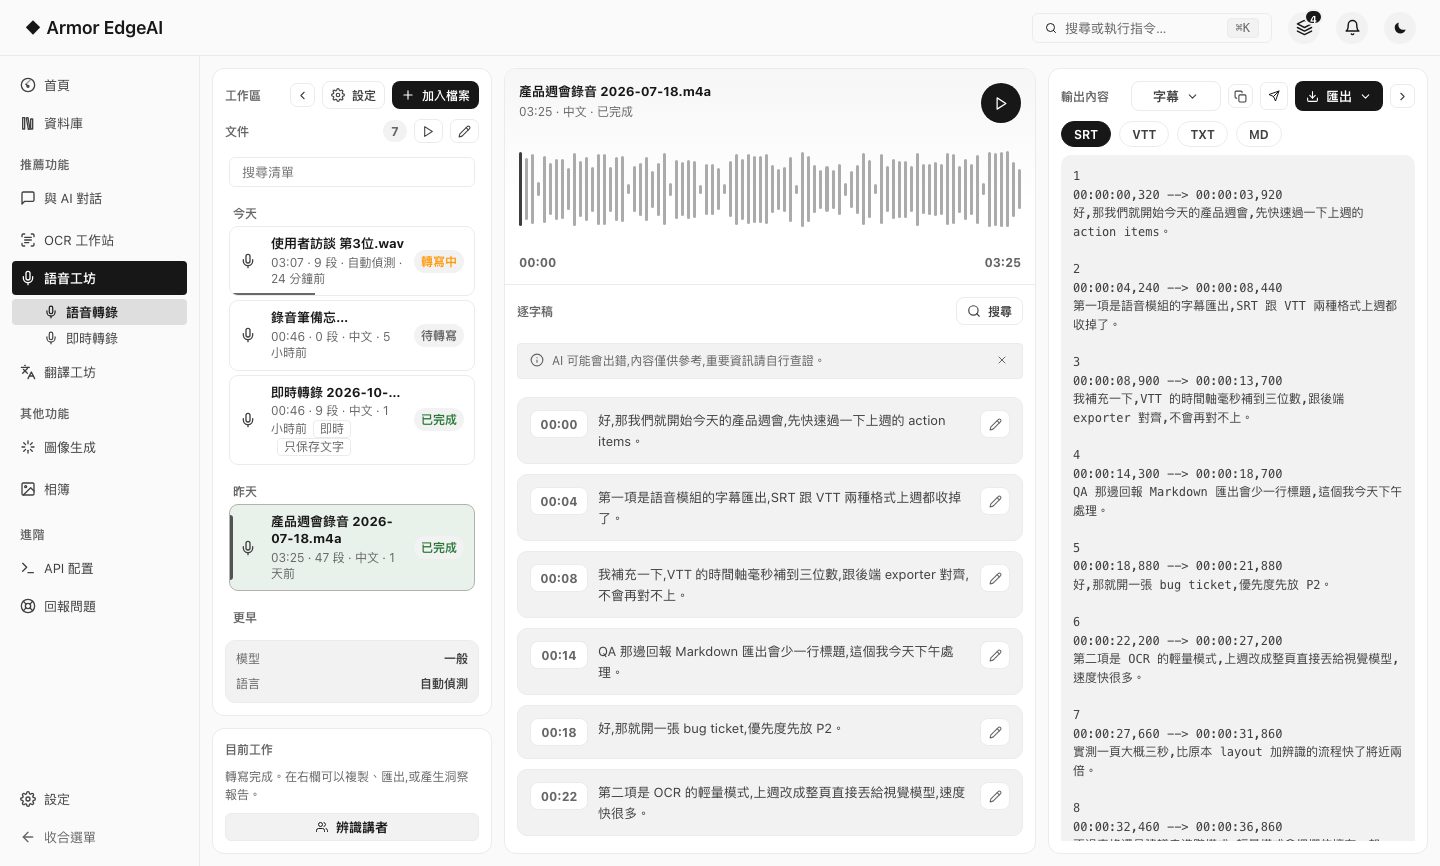
会議録音・インタビュー・動画を放り込むだけで、ローカルエンジンが文字起こし。動画はシアターモードで字幕同期再生、文字起こしからは要約・マインドマップ・Q&A を生成できます。

  • 音声も動画も一般的な音声 / 動画形式をそのままインポートして文字起こし。
  • 同期トランスクリプト再生位置に合わせてテキストがハイライト;行をクリックでその時点へジャンプ。
  • 字幕エクスポートトランスクリプトを字幕ファイルとして書き出し。
  • インサイトレポート文字起こし完了後、ワンクリックで要約・マインドマップ・Q&A を生成。
実行場所100% ローカル文字起こし入力音声 / 動画ファイル / リアルタイム録音(Beta)
このモジュールを見る
音声スタジオの 3 ペイン文字起こしワークステーション画面
画面はサンプルデータです

MODULE 06 / 06

画像生成

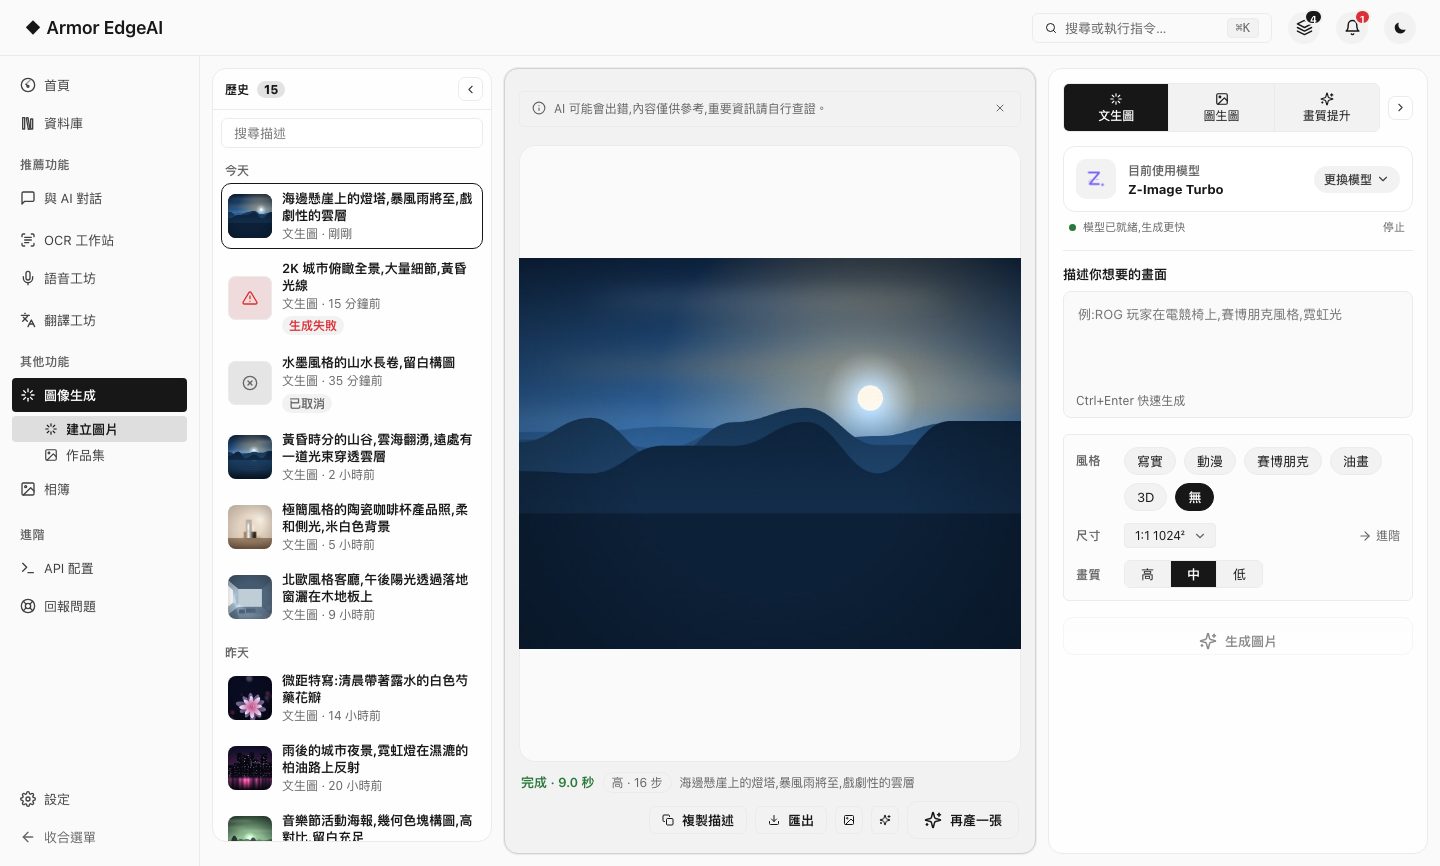
自分の GPU で生成:テキストからも下絵からも、複数のオープンソースモデルとスタイルを選んで最大 2K 解像度で出力し、作品は自動でギャラリーへ — 行列なし、枚数制限なし、アップロードなし。さらに、既存の画像を 4 倍に拡大してディテールを再構築する画質向上ツールも付属します。

  • txt2img + img2imgテキストからの生成(txt2img)と画像からの生成(img2img)。一文の説明から、または一枚の下絵から(img2img は対応モデルのみ)。
  • 複数モデル速度優先か品質優先か、用途でモデルを選択。
  • 2K 出力最大 2K。まず下絵を描き、次に拡大してディテールを再構築する 2 段階方式です。
  • 画質向上どんな画像でも 4 倍に拡大してディテールを再構築。境界をドラッグして前後をその場で比較できます。
実行場所100% ローカル GPU 生成解像度最大 2K
このモジュールを見る
画像ワークベンチの画面
画面はサンプルデータです

02 — Honest Specs

スペックを、ありのままに

数字は多くありませんが、どれもデータと体験に直結します。実際は機種とモデル選択に依存します。

6統合モジュールチャット / アルバム / 文書 / 翻訳 / 音声 / 画像
0テレメトリーとアップロード使用統計は一切収集しません
128Kコンテキスト上限選択モデルに依存
~200 MBインストーラーモデルは必要時に別途 DL
100%ローカル推論AI はオフラインでも動作

推奨構成

全モジュールは標準構成で動作します。独立 GPU と 16 GB 以上のメモリを備えた機種なら、画像生成や大きめのモデルで最良の体験に。アプリがハードウェアに合わせてモデルを推奨します。

ストレージ

モデルは選択に応じてダウンロード、よくある組み合わせで約 3–25 GB。モデル管理でいつでも追加・削除でき、使用量は一目で分かります。

言語

インターフェースは繁体字中国語・簡体字中国語・英語・日本語に対応し、設定で切り替えられます。チャットと翻訳のモデルは多言語対応(中・英・日ほか、モデル依存)。

アップデート

1.0 以降の新バージョンはバックグラウンドでダウンロードし、次回起動時に適用。モデルとエンジンの更新も作業を妨げません。0.63.7 からは、アプリ内で直接 1.0 にアップデートできます。

Next

マシンが届いたら、4 ステップ

ダウンロードとインストール、同意、シリアル認証、モデルダウンロード — 時間のほとんどはダウンロード待ちです。

はじめる